Кому отправлять сообщение, если бюджет ограничен? В ECCO отбор доверили ML-модели: она находит клиентов, которые скорее всего купят в ближайшие две недели. За год выручка от SMS выросла на 32%.
+32% к выручке от SMS. В ECCO внедрили ML‑модель вероятности покупки
ECCO — магазины обуви и аксессуаров. Компания полностью контролирует процесс создания обуви: от выделки кожи до примерки модели покупателем
Масштаб бизнеса.
303 магазина в России
Задача
Получать больше выручки от SMS-канала
Решение
Отправлять SMS сегменту с высокой вероятностью покупки
ИТ.
Сайт и бэкофис собственной разработки, система BI-аналитики Power BI, платформа персонализации маркетинга и цен Mindbox
Результат
+32% к общей выручке от SMS+13,4% к выручке с каждого SMS
Срок.
1 год
13 октября 2026
Раньше сегмент для акционных SMS в ECCO собирали ручными фильтрами, и в него попадали в том числе клиенты, которые не собирались покупать в ближайшее время. Часть промобюджета тратили на сообщения, которые не приносили выручку. Поэтому команда ECCO внедрила ML-модель вероятности покупки. Алгоритм оценивает, кто из клиентов, скорее всего, оформит заказ в следующие две недели, и SMS о предстоящей акции отправляют в первую очередь этому сегменту.
Теперь бюджет на промо тратят эффективнее и получают больше выручки с каждого SMS. В кейсе расскажем, как устроена ML-модель и как проверяли ее эффект.
Результаты
-
+32%к общей выручке от SMS
-
+13,4%к выручке с каждого SMS
Сравнивали периоды с разными подходами к сегментации: Q1 2026 и 2025 года. Данные Coffee Analytics и Mindbox, модель атрибуции — last non-direct touch по доставке
SMS дорожает каждый год, а бюджет на этот канал у нас ограничен. При этом от каждой акции мы ожидаем определенной выручки — значит нужно охватить достаточно людей, но не платить за тех, кто сейчас покупать не собирается.
Мы несколько лет собирали сегменты для промо ручными фильтрами, и с каждым годом подбирали их точнее. Но таких показателей, как после внедрения ML-модели, не получали ни разу.
Сейчас модель подсказывает, кому отправить промо в первую очередь. Таких клиентов обычно меньше, чем нужно охватить, чтобы акция принесла плановую выручку. Поэтому остальных добираем, как и раньше, — ручными фильтрами. Так мы выполняем план по выручке и видим, на что тратим бюджет.
Как работает ML-модель вероятности покупки
Модель определяет вероятность покупки для каждого клиента. Она учитывает три типа данных:
- поведение на сайте и в приложении — из Mindbox;
- история заказов — из CRM-системы, а с мая 2026 года — из Mindbox;
- дополнительные поведенческие события — из Яндекс Метрики и AppMetrica.
Для рассылки берут клиентов с высокой вероятностью покупки. Порог задают под конкретную задачу: иногда только самых «горячих», иногда сегмент пошире.
Модель вычисляет вероятность того, что клиент оформит заказ в ближайшие две недели. Этот срок мы выбирали из четырех вариантов: неделя, две, три или четыре.
Модель обучается на данных о клиенте: изучает его поведение на конкретную дату и проверяет, оформил ли он заказ в следующие несколько дней. Если взять неделю, таких случаев в выборке мало и учиться не на чем. Если месяц — их достаточно, но многие уже не связаны с тем поведением, которое модель прослеживала: человек смотрел товар сегодня, а купил через месяц совсем по другому поводу. Две недели оказались золотой серединой.
Целевым действием выбрали оформление заказа, потому что оно теснее всего связано с поведением на сайте. Выкупит клиент заказ или вернет, зависит уже от доставки, размера и других причин, на которые поведение до покупки не влияет.
Первая версия модели работала только на двух источниках данных: Mindbox и CRM-системе. И не учитывала поведенческие события из Яндекс Метрики и AppMetrica. Опирались на понятные маркетологу сигналы: как давно человек заходил на сайт, сколько заказов уже сделал, когда был последний и какой у него средний чек. Всего таких признаков собрали 43, и большинство описывали покупки, а не поведение пользователя на сайте.
Чтобы прогноз стал точнее, к данным добавили поведение из Яндекс Метрики и AppMetrica — они собирают больше событий о действиях клиентов:
- действия с корзиной,
- добавление товаров в избранное,
- просмотры товаров и категорий,
- выбор цвета,
- авторизации,
- число просмотренных страниц,
- визиты на определенные страницы,
- общая длительность визитов на сайт.
Сложнее всего было связать поведенческие данные об одном человеке в разных системах. Пользователь заходит с телефона, компьютера и из приложения, часто без авторизации, и в каждой системе это выглядит как несколько разных записей.
Как связали идентификаторы Mindbox, Яндекс Метрики и AppMetrica
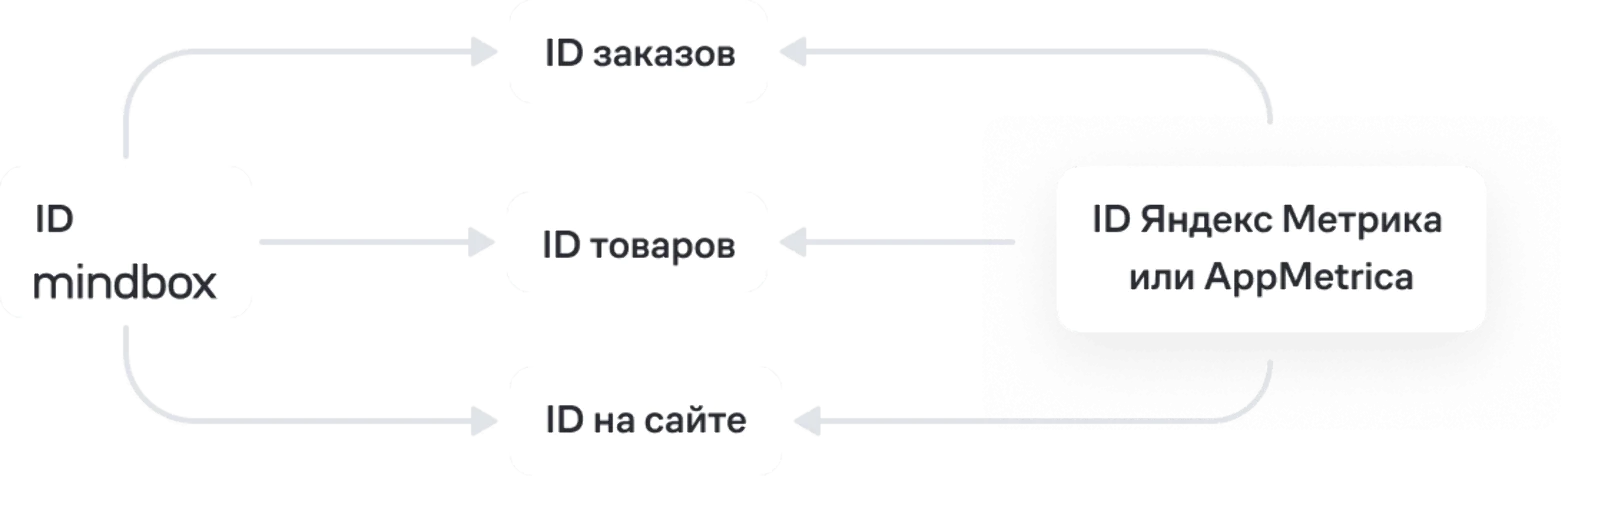
Связать данные помог единый профиль в Mindbox: у каждого клиента там один идентификатор, к которому привязаны все действия. К нему и подтягивали идентификаторы Яндекс Метрики и AppMetrica.
Сопоставляли по общим действиям. В Mindbox мы видим профиль клиента, а в Метрике и AppMetrica — идентификаторы браузеров и устройств, с которых человек заходил. Если в обеих системах есть заказ с одним и тем же номером, это один человек, и профиль можно связать с устройством.
С просмотрами сложнее. Один и тот же товар в одно и то же время могут смотреть разные люди с разных устройств, поэтому одно устройство иногда связывалось сразу с несколькими профилями Mindbox. Чтобы понять, какой из них настоящий, каждой паре «профиль — устройство» присваивали вес: насколько надежное действие их связало, как часто и как давно оно происходило. Заказ указывает точнее просмотра, а недавние события важнее давних. Верным считали профиль с наибольшим весом. Когда стали сверять просмотренные страницы, доля совпадений выросла с 50 до 60% — это сотни тысяч записей.
Так мы связали около 65% идентификаторов. Часть совпадений отсеяли как ненадежные: люди меняют устройства, устаревают куки. Данные Метрики в итоге добавили примерно к трети клиентов в базе Mindbox, а для остальных модель по-прежнему опирается только на Mindbox и CRM-систему.
Признаков стало 111 вместо 43, а качество модели выросло в 1,4 раза. Измеряли его метрикой F1: она показывает, сколько среди отобранных клиентов оформили заказ и скольких покупателей модель не нашла. На практике это значит, что при том же размере сегмента в него попадает больше тех, кто действительно купит.
Восемь наиболее значимых признаков модели из 111
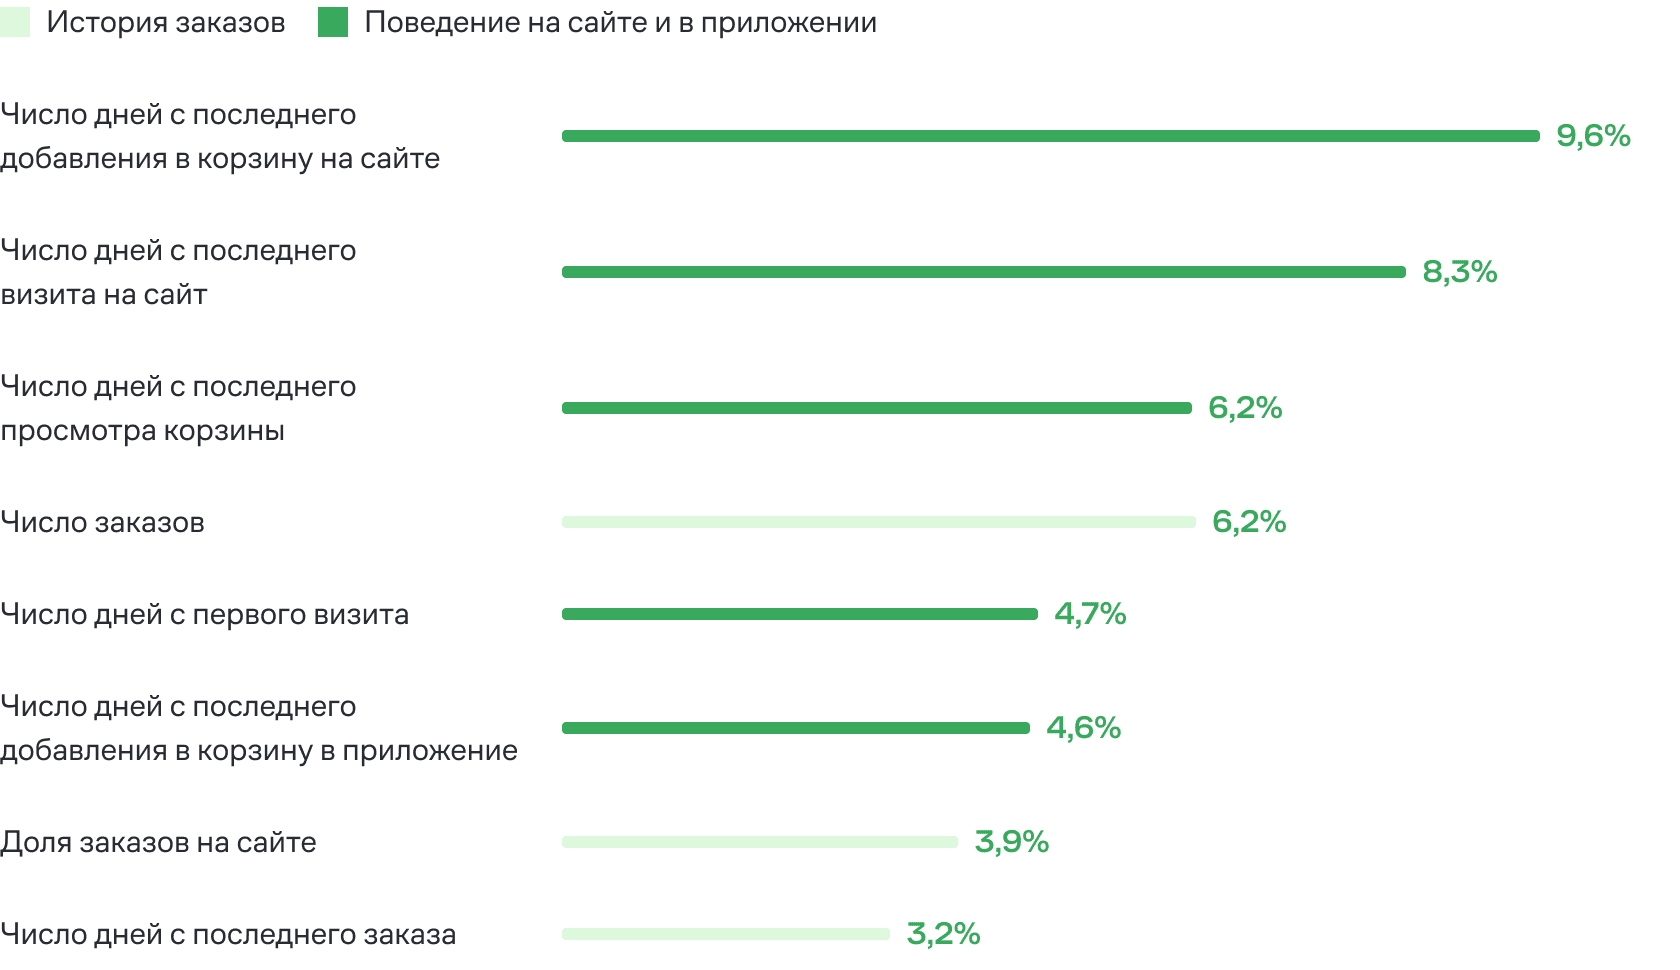
Проценты показывают вклад признака в прогноз, вместе все признаки дают 100%. Большинство поведенческие: на них приходится 80% влияния
Как измерили эффект модели с помощью АВ‑теста
-
+66%к выручке с каждого SMS
-
+0,5 п. п.к конверсии из SMS в заказ
Сравнивали результаты проморассылок по двум сегментам: с высокой вероятностью покупки и на ручных фильтрах. Данные Coffee Analytics и Mindbox, модель атрибуции — last non-direct touch по доставке
Сравнивать результаты промо из разных периодов не всегда корректно: меняются сезон, офферы, объем отправок. Чтобы точнее измерить эффект отбора по вероятности покупки, мы запустили АВ-тест, где отличается только отбор сегмента. Результаты оценивали через месяц, когда закрылось окно атрибуции — срок, в течение которого заказ связывают с рассылкой.
Гипотеза. Получатели SMS из сегмента с высокой вероятностью покупки оформляют заказ чаще, чем те, кого отобрали ручными фильтрами.
Сегменты. Активную базу случайным образом разделили на две части — еще до того, как модель посчитала вероятность покупки. В первой половине сегмент собрала модель, во второй его собрали ручными фильтрами, как делали раньше. Так у обоих способов отбора были равные условия. Остальных получателей добрали отдельно, их результаты в сравнение не входят.
Механика. Обеим группам отправили одну и ту же рассылку с одинаковым оффером.
Метрики. Конверсия из SMS в заказ и выручка с каждого сообщения.
Конверсия в заказ у сегмента, отобранного ML‑моделью 1,5% против 1%
Группа получателей
Конверсия из SMS в заказ
Выручка с каждого SMS
Сегмент, отобранный ML‑моделью
1,5%
196 ₽
Сегмент на ручных фильтрах
1,0%
118 ₽
Статистическая значимость — 95%
Цель АВ-теста была в том, чтобы проверить, какой способ отбора работает лучше для промо: сегменты активных на наших стандартных фильтрах или собранные ML-моделью. У сегмента, отобранного моделью, конверсия в заказ оказалась на 0,5 п. п. выше, чем у сегмента на ручных фильтрах, а выручка с каждого SMS — на 66%.
Значит, ML-сегментация по вероятности покупки приносит больше выручки — ее можно масштабировать на все массовые промо.
Чтобы проверить устойчивость эффекта, в Coffee Analytics посчитали выручку с сообщения по всем рассылкам, в которых с декабря 2025 года использовали сегмент с высокой вероятностью покупки, отобранный ML-моделью.
Выручка с каждого SMS в рассылках по сегменту, отобранному ML-моделью
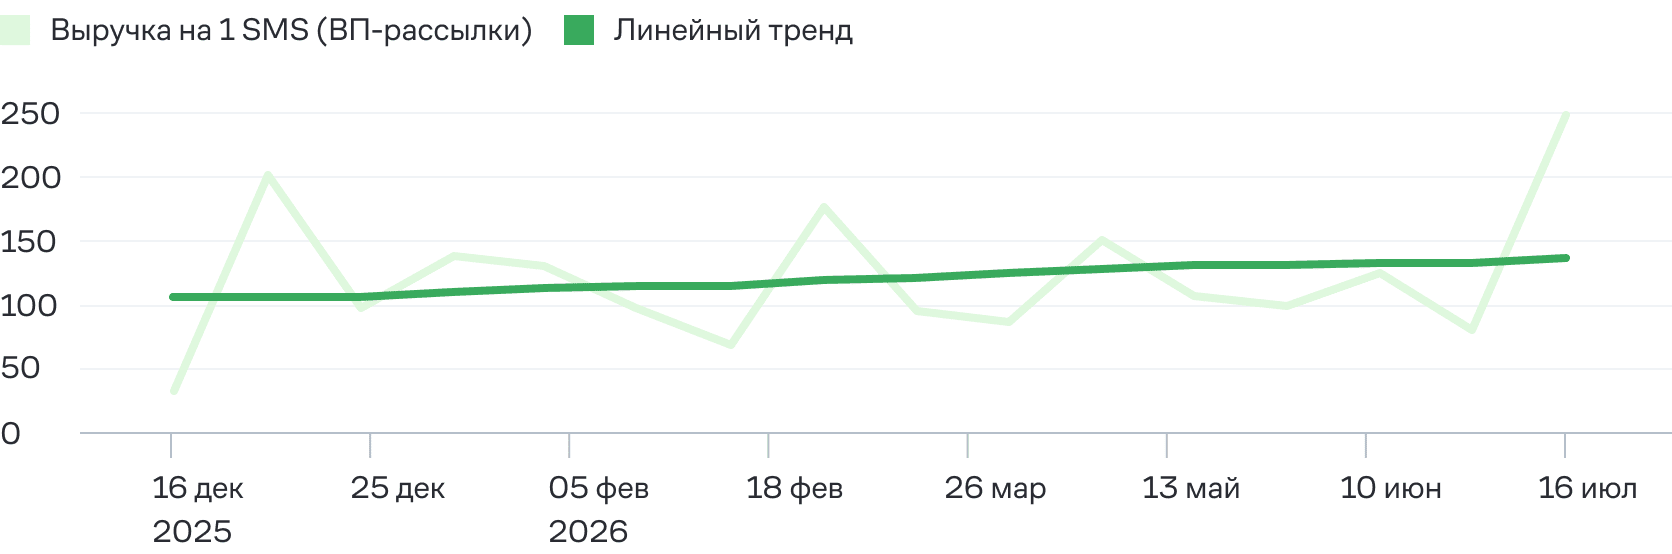
Результаты с декабря 2025 года, когда модель заработала на данных Яндекс Метрики и AppMetrica
Иногда результаты АВ-теста считают разовым успехом. Но на графике видно, что седьмой месяц подряд выручка с сообщения не снижается, а понемногу растет — с тех пор, как модель заработала на данных Яндекс Метрики и AppMetrica. Тренд пологий из-за объемов рассылок: в сегмент попадают не только клиенты с высокой вероятностью покупки, но и те, у кого она средняя. На узком сегменте разница была бы заметнее.
Как ML-модель растит выручку с сообщения в проморассылках
Сегмент с высокой вероятностью покупки Coffee Analytics считает на своей стороне и передает нам файлом, а мы загружаем его в Mindbox. Настроить автоматическую передачу мы можем, но пока в этом нет смысла: сегменты модели используем только в массовых рассылках, и на скорость это не повлияет. В планах интеграция есть ― пригодится, когда будем подключать модель к автоматическим рассылкам.
Остальных получателей добираем там же, в Mindbox, ручными фильтрами. Для промо выбираем сегмент активных клиентов: тех, кто покупал за последние два года, но не последние полгода, и при этом кликает по ссылкам в SMS или открывает письма.
Рассылки по этим сегментам отправляем по отдельности и сравниваем результаты — так мы видим, какой отбор приносит больше конверсий в заказ и выручки с сообщения.
Акция «1+1=3»: +44% к выручке с сообщения
В ECCO проводят акцию «1+1=3» примерно два-три раза в год. Раньше проморассылку в SMS-канале отправляли по всей активной базе. Например, в июле 2025 года конверсия из SMS в заказ была 0,29%. Через год, в июне 2026-го, для той же акции собрали сегмент с высокой вероятностью покупки, а остальных добрали ручными фильтрами. Конверсия в заказ выросла на 0,17 п. п., а выручка с сообщения — на 44%.
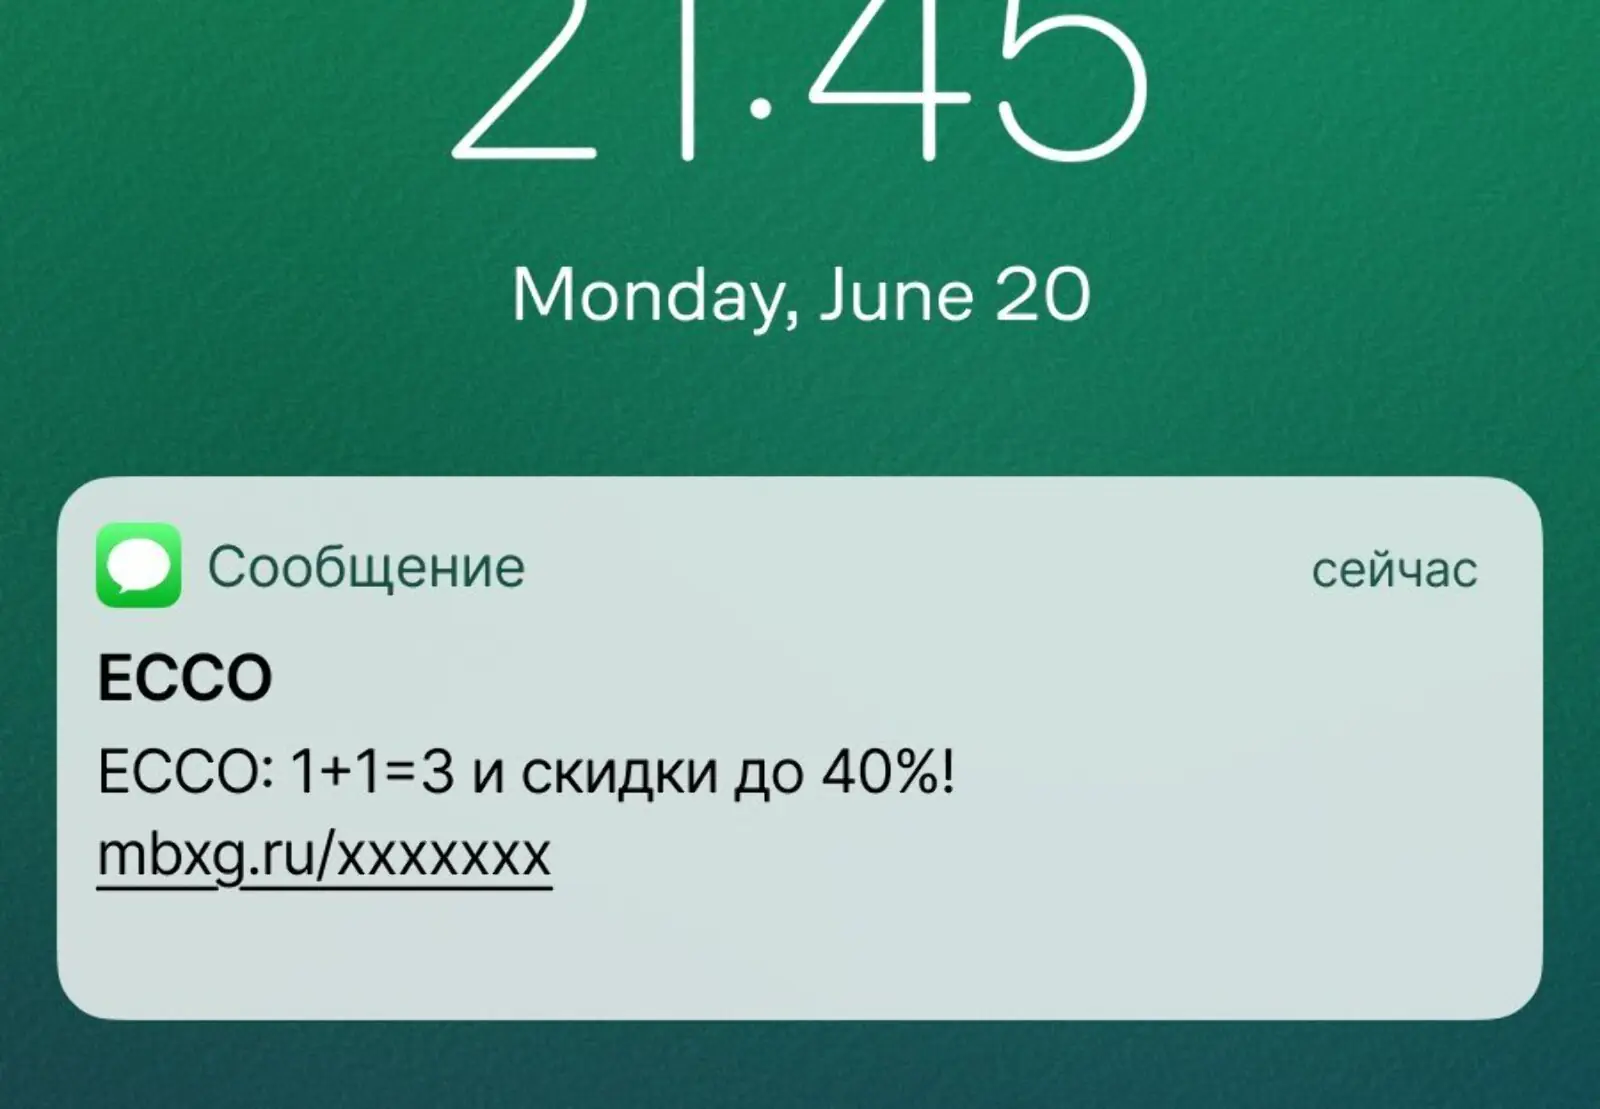
Оффер в акции два года был одинаковый. Конверсия в заказ в июле 2025 года — 0,29%, а в июне 2026 года — 0,46%
Акция Extra Sale: +36% к выручке с сообщения
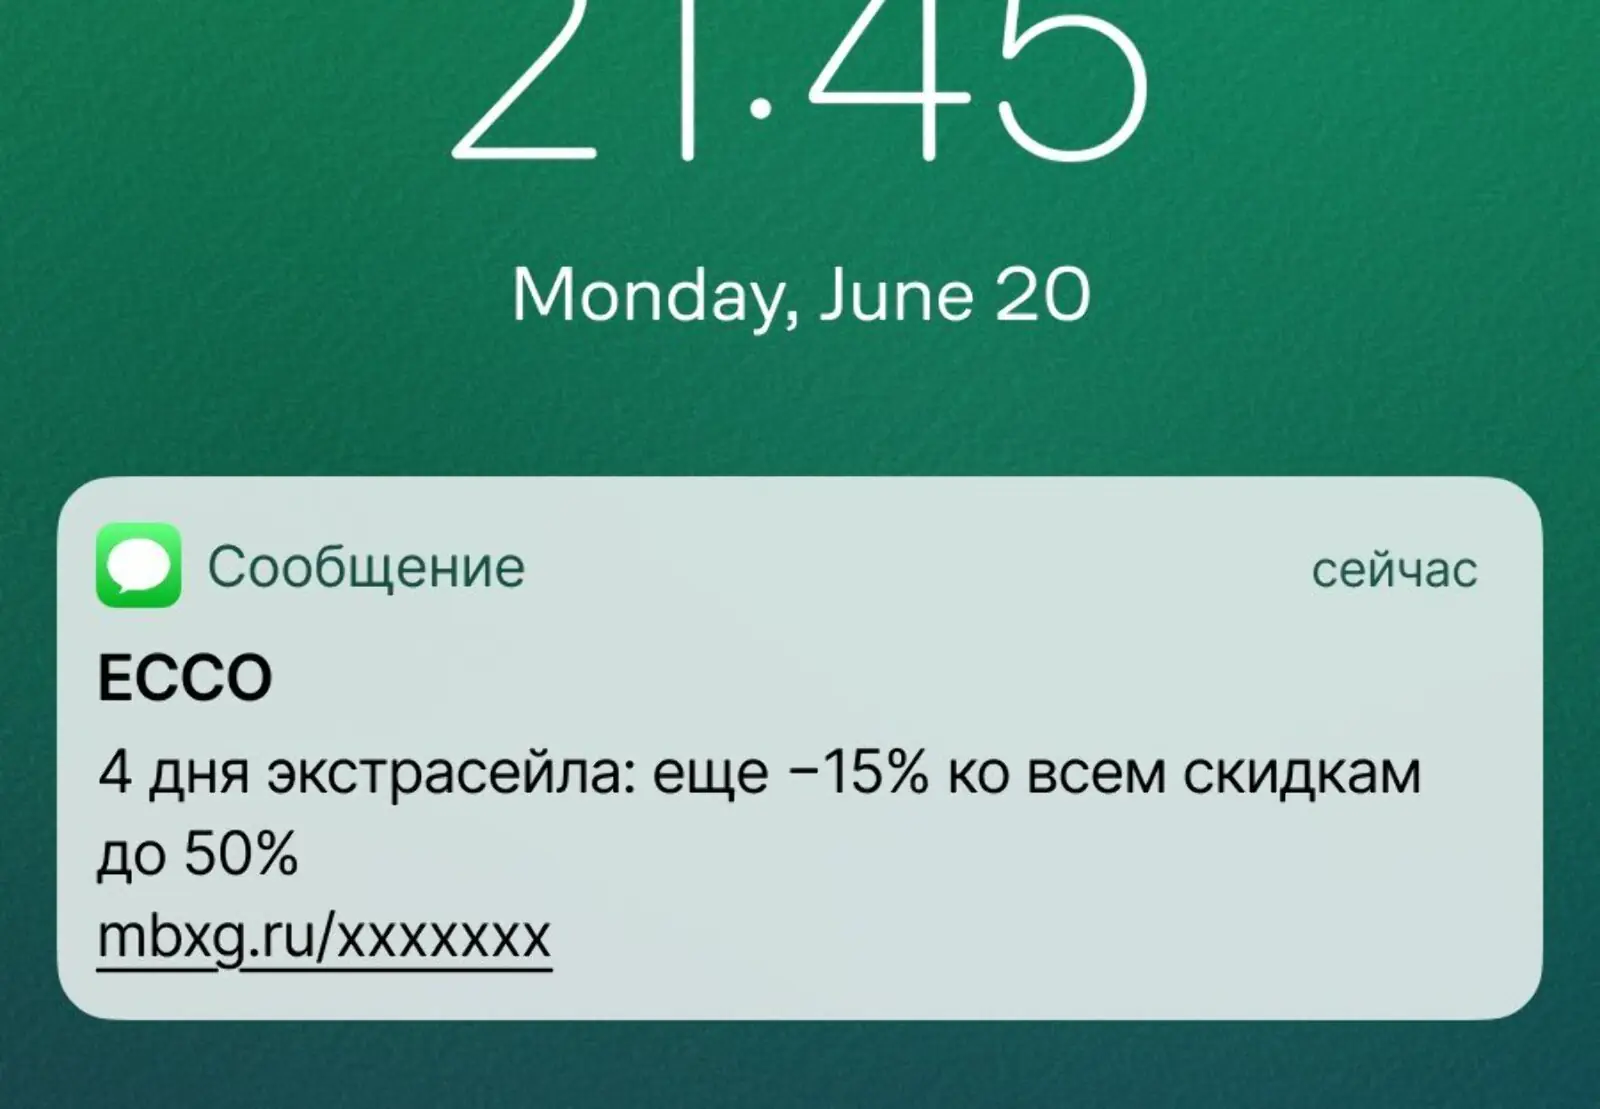
Extra Sale — короткая распродажа на несколько дней с крупными скидками. Год назад промо отправляли по всей активной базе. Конверсия в заказ составила 0,64%. В 2026 году скидка на распродаже была меньше, но рассылка по клиентам с высокой вероятностью покупки показала результаты лучше, чем годом ранее: конверсия в заказ оказалась выше на 0,22 п. п., а выручка с сообщения — на 36%.
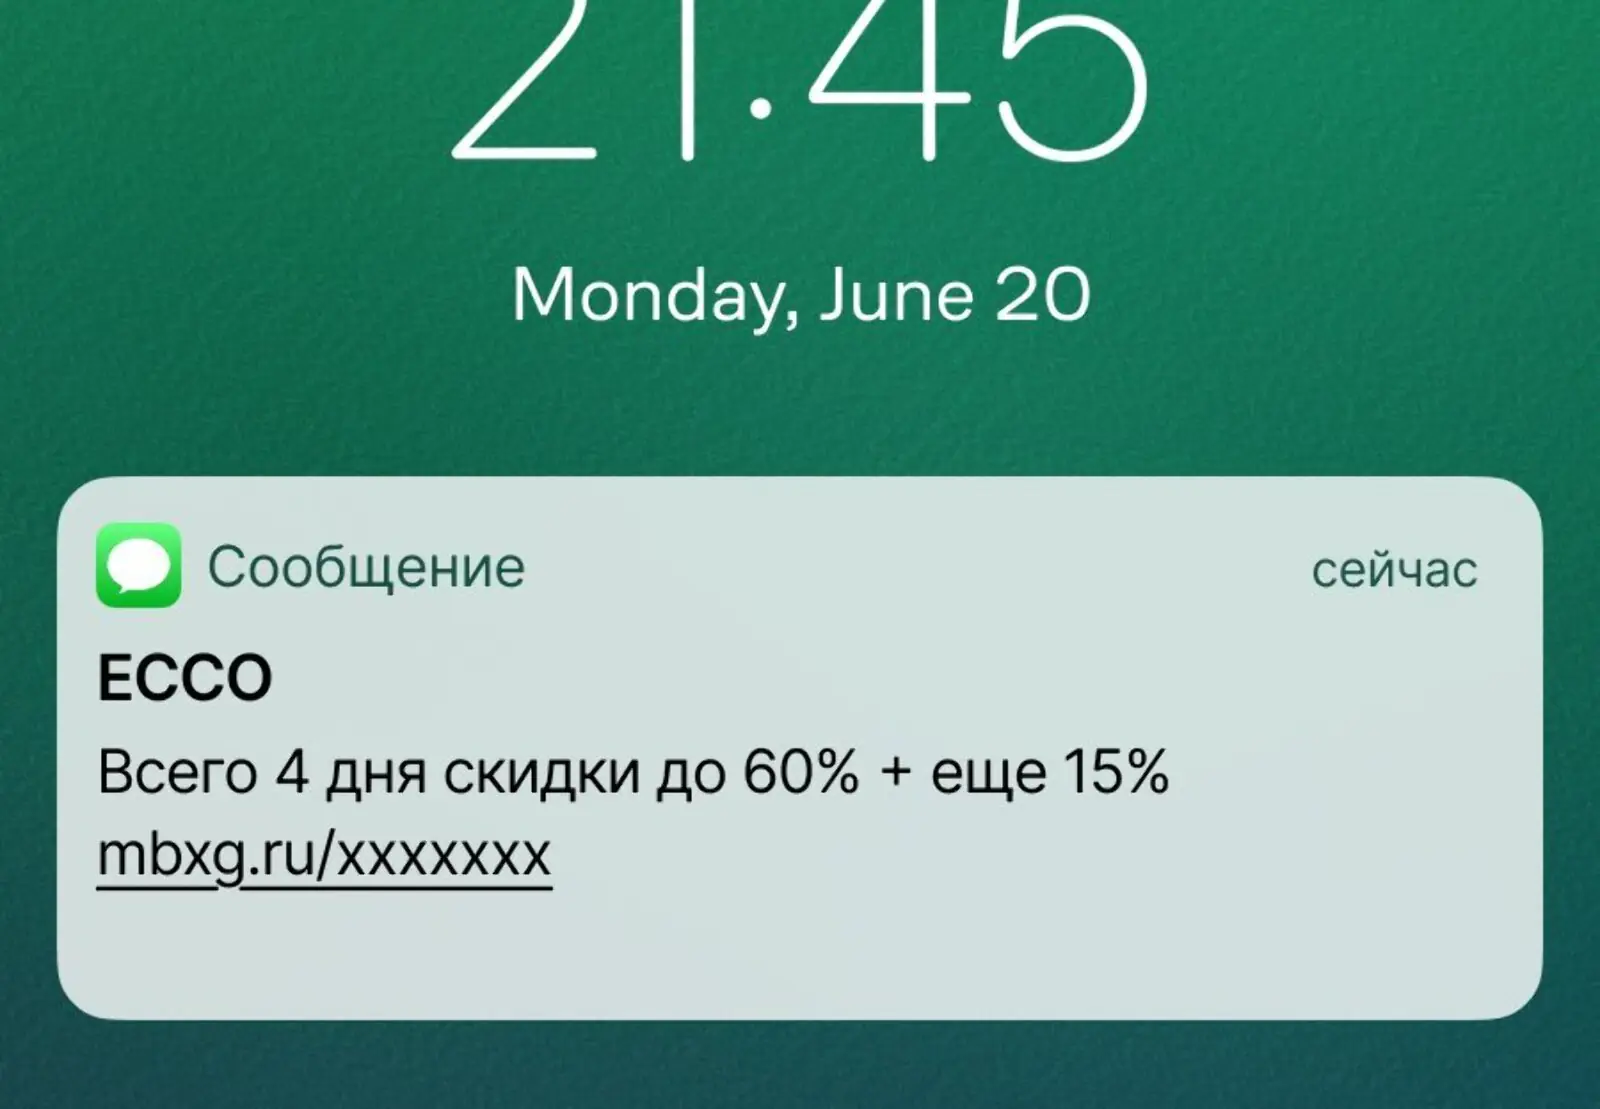
Промо в феврале 2025 года. Конверсия в заказ — 0,64%
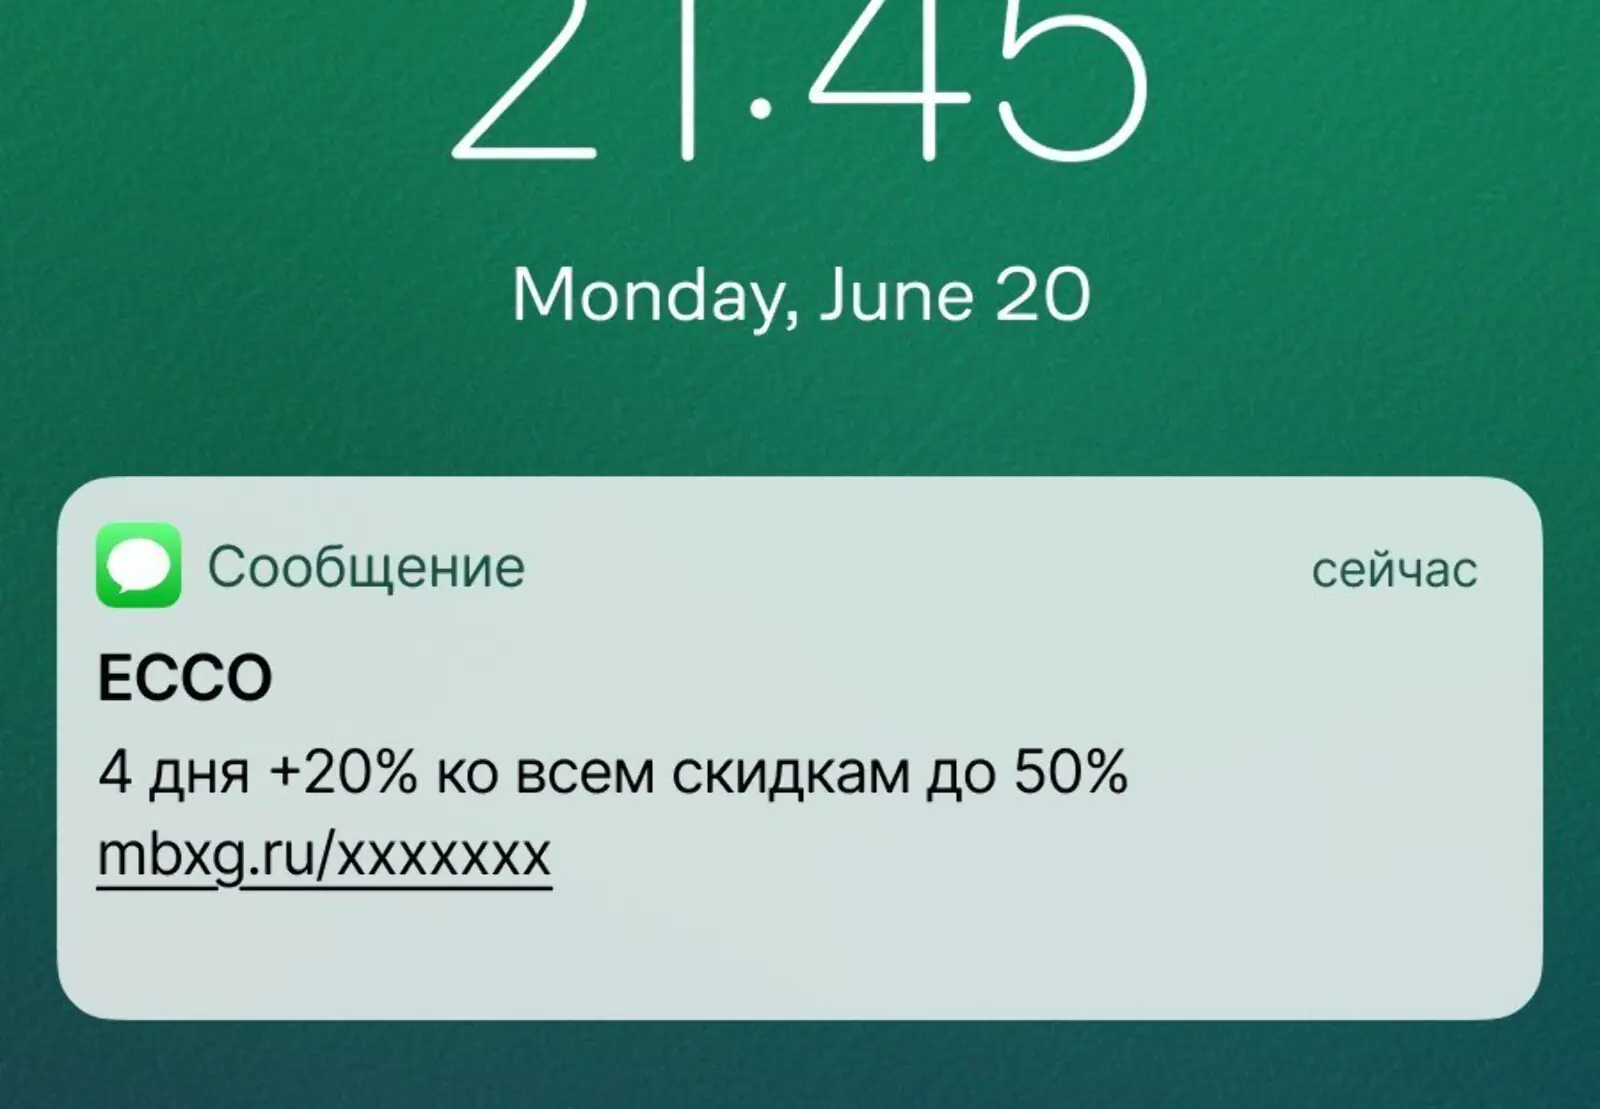
Промо в январе 2026 года. Конверсия в заказ 0,86%
Майская распродажа: +10% к выручке с сообщения
В мае на фэшн-рынке начинается сезон скидок: в магазины привозят летнюю коллекцию, а демисезонную обувь нужно допродать. Весеннюю распродажу проводит и ECCO. Промо отправляли на активную базу и по сегменту с высокой вероятностью покупки.
Отбор по вероятности покупки повысил конверсию из SMS в заказ на 0,14 п. п., а выручку с сообщения — на 10%.
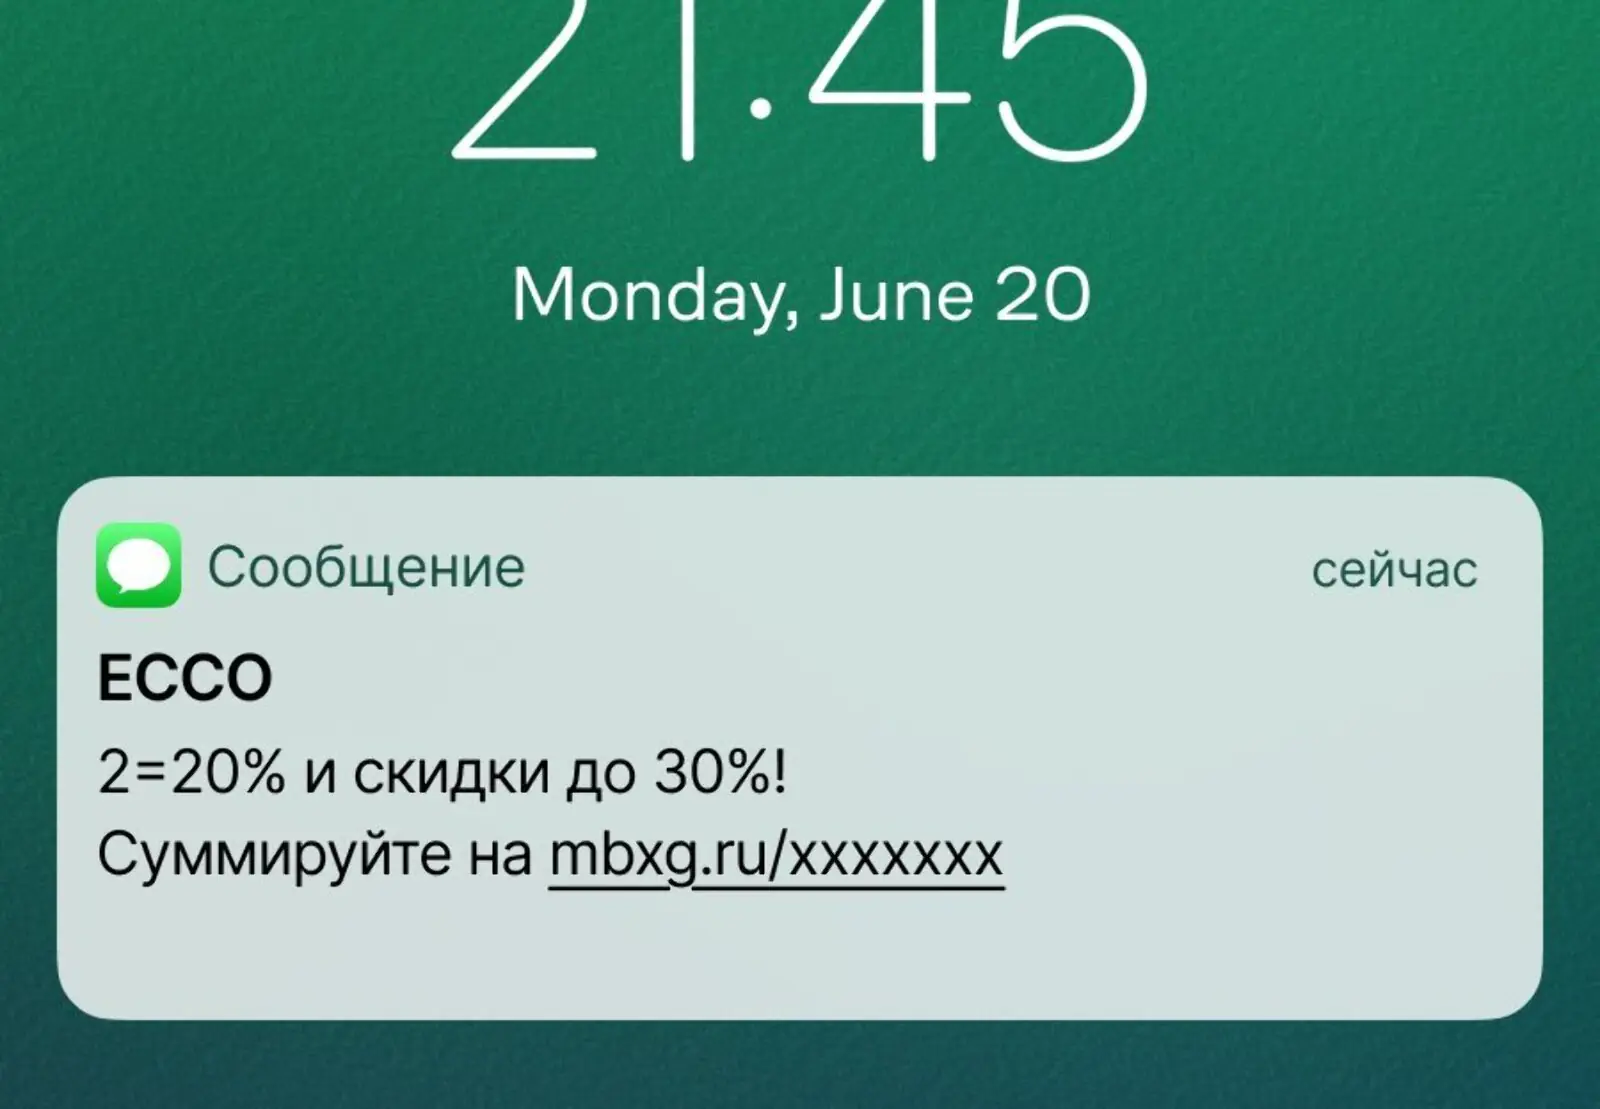
Промо в мае 2025 года. Конверсия в заказ 0,37%
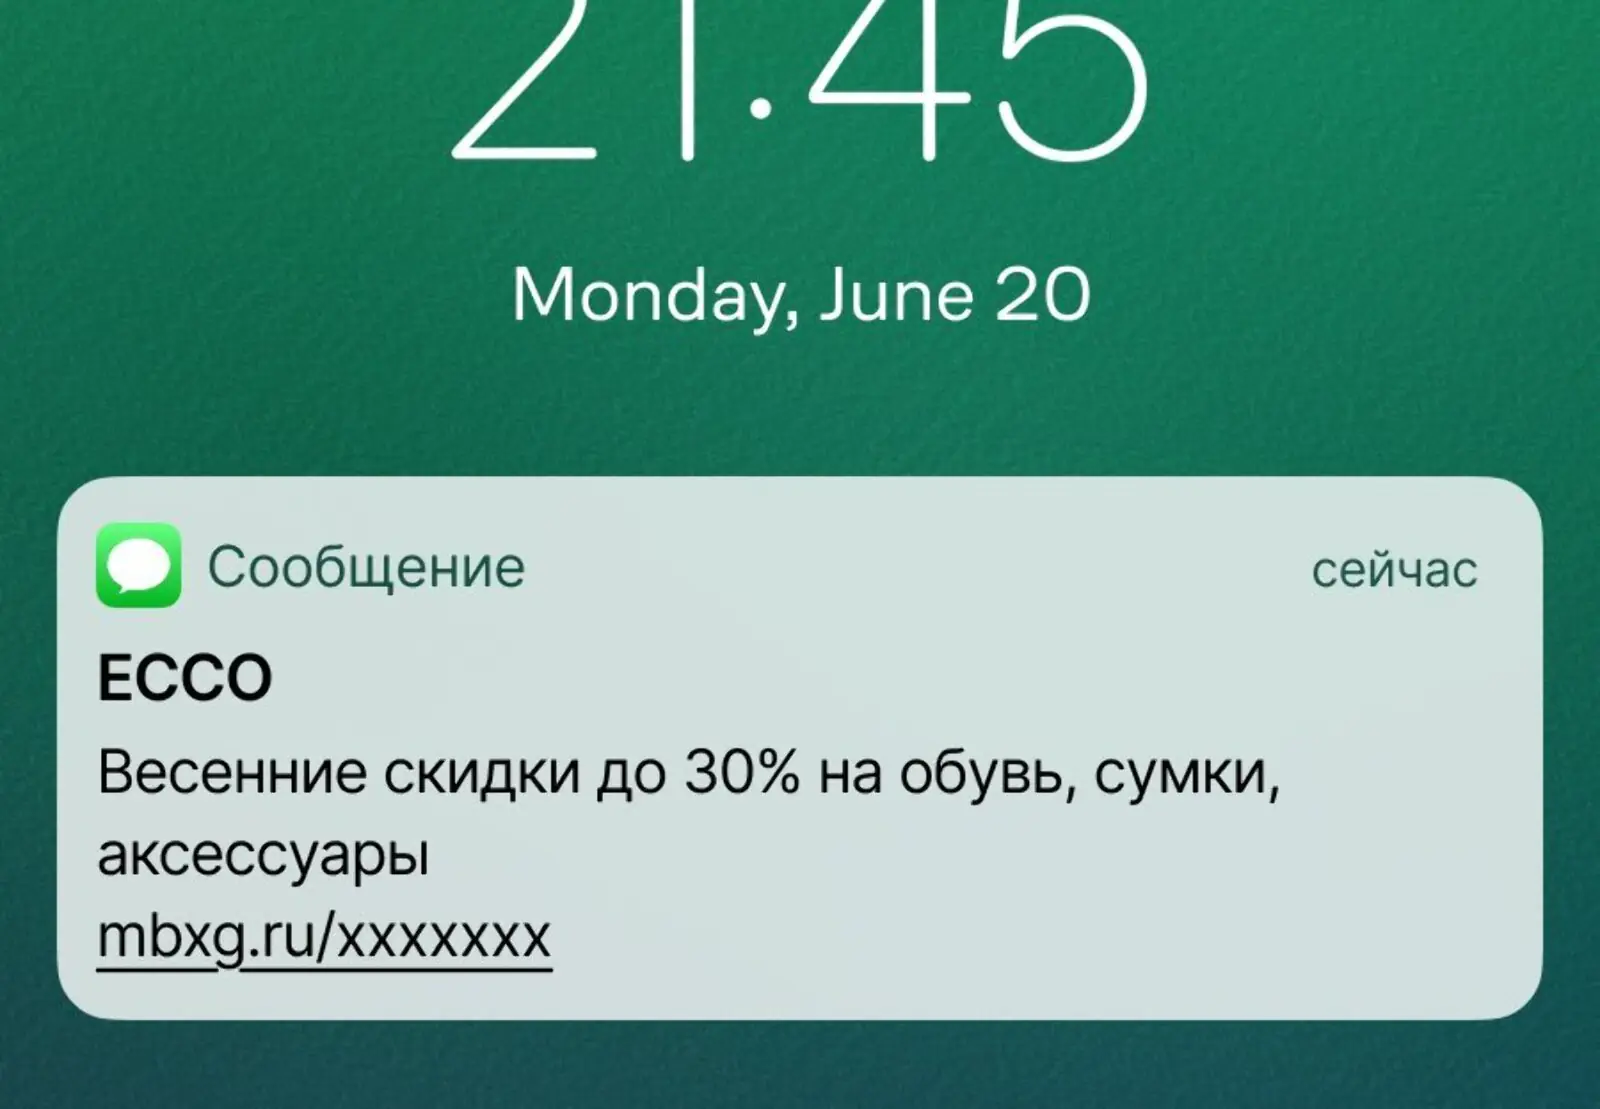
Промо в мае 2026 года. Конверсия в заказ 0,51%
Планы
Следующий шаг — масштабировать модель вероятности покупки с массовых рассылок на автоматические. Еще хотим проверить комбинации сигналов. Например, клиент заходил на страницы новой коллекции последние три дня, и при этом у него высокая вероятность покупки — такому можно отправить персональный оффер.
Дальше настроим каскады: сначала отправляем письмо и мобильные пуши, а SMS — только тем, кто не отреагировал и близок к заказу. Для этого нужна автоматическая передача сегментов, чтобы система сама забирала клиентов из сценария, считала вероятность покупки и возвращала сегмент на отправку. Так мы снизим расходы на SMS без потери в выручке.
P. S. В этой истории мы рассказывали о наших продуктах CDP и Рассылки. Узнайте о продуктах подробнее на их страницах или в разговоре с консультантом.
Что такое вероятность покупки и как ее считают?
Вероятность покупки ― оценка того, оформит ли клиент заказ в заданный период, например в ближайшие две недели. Ее считают ML-модели: они обучаются на истории, где известно, купил клиент или нет, и ищут закономерности в поведении. Сильнее всего на прогноз влияет свежесть действий ― как давно человек заходил на сайт, смотрел товары, добавлял их в корзину. Оценку используют, чтобы отбирать аудиторию для рассылок и начинать с тех, кто ближе к заказу.
Как собрать сегмент для SMS-рассылки по вероятности покупки?
Сначала модель оценивает каждого клиента в базе: насколько он близок к заказу. Дальше маркетолог решает, с какой оценки брать клиентов в рассылку ― чем строже отбор, тем точнее сегмент, но меньше охват. Модель может работать внутри платформы рассылок или на стороне подрядчика: во втором случае готовый сегмент загружают файлом или через интеграцию.
Как провести АВ-тест рассылки, чтобы результат был корректным?
Главное условие ― сопоставимые группы. Базу делят случайно и только потом применяют к половинам разные подходы. Результат проверяют на статистическую значимость и снимают после закрытия окна атрибуции, иначе часть заказов не попадет в расчет.